ローカルLLMの会話で学んだ、測り方を疑う大切さ
国づくりのシミュレーションゲーム「クロニクル・オブ・エンパイア」に、女王たちと自由な言葉で語らう遊びを入れました。返事を書くのは、手元のMacで動く小さなAI(ローカルLLM)です。費用は0円です。
AIに開発やテストを手伝ってもらっている方に向けて書きます。まずゲームの全体像と、女王との会話(以下、TRPGモードと呼びます)に入る流れを紹介します。次に、会話の仕組みを図で説明します。最後に、AIに作ってもらった会話のテストを見ていて気づいた、テストの偏りについて書きます。
この記事は「ゲーム開発日記」の3本目です(1本目は判断と語りを分ける、Jev的なゲーム開発、2本目は先行事例調査の重要性を学んだマップエディタ作り)。今回の会話の仕組みは、Claude Codeが設計からコードとテストまでを書き、HERMES(このMacで動いている別のAIエージェント)がゲームの本体に取り込みました。私は要望を出し、結果を見て判断しました。
ゲームの全体像:女王たちとの会話を楽しみたい
このゲームでは、遊ぶ人は主人公として、小さな国の主(あるじ)になります。宰相に「荒れ地を開墾せよ」のような自由な言葉で命令を出し、国を育てます。命令は1日に9回までで、9回目のあとに1日が締まります。周りには北・西・東・南の4つの国があり、それぞれ女王が治めています。
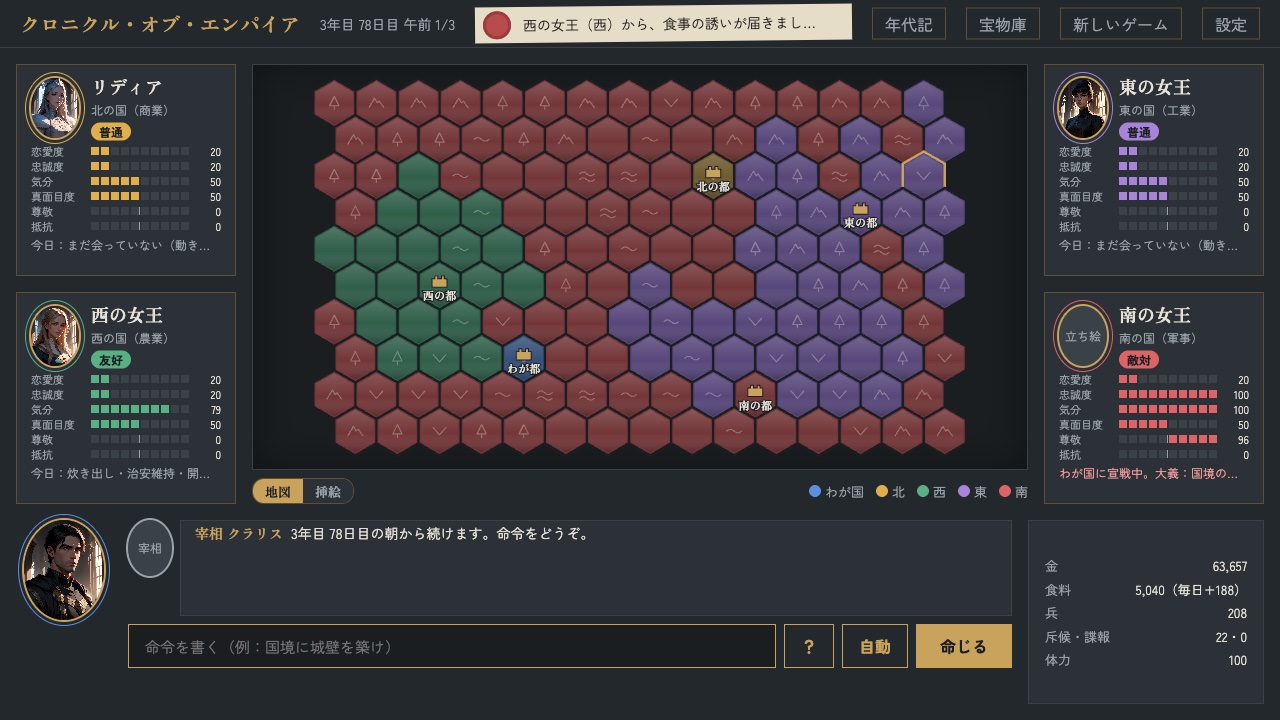
作っている途中で、女王たちとの会話も楽しみたいと考えました。そこで、TRPGの要素を取り込むことにしました。TRPG(テーブルトークRPG)は、参加者どうしの会話で物語を進める遊びです。このゲームでは、国どうしの交流のために、女王と会食をするという形にしました。
もちろんゲームなので、会話はただのおしゃべりでは終わりません。命令や会話、出来事によって、恋愛に発展したり、尊敬されたり、逆に軽蔑されたりします。女王の札には、心の目盛りを6つ置きました。恋愛度・忠誠度・気分・真面目度・尊敬(軽蔑〜尊敬)・抵抗(屈服〜抵抗)です。
TRPGモードに入るまで
図1は、ゲームの1日の流れです。
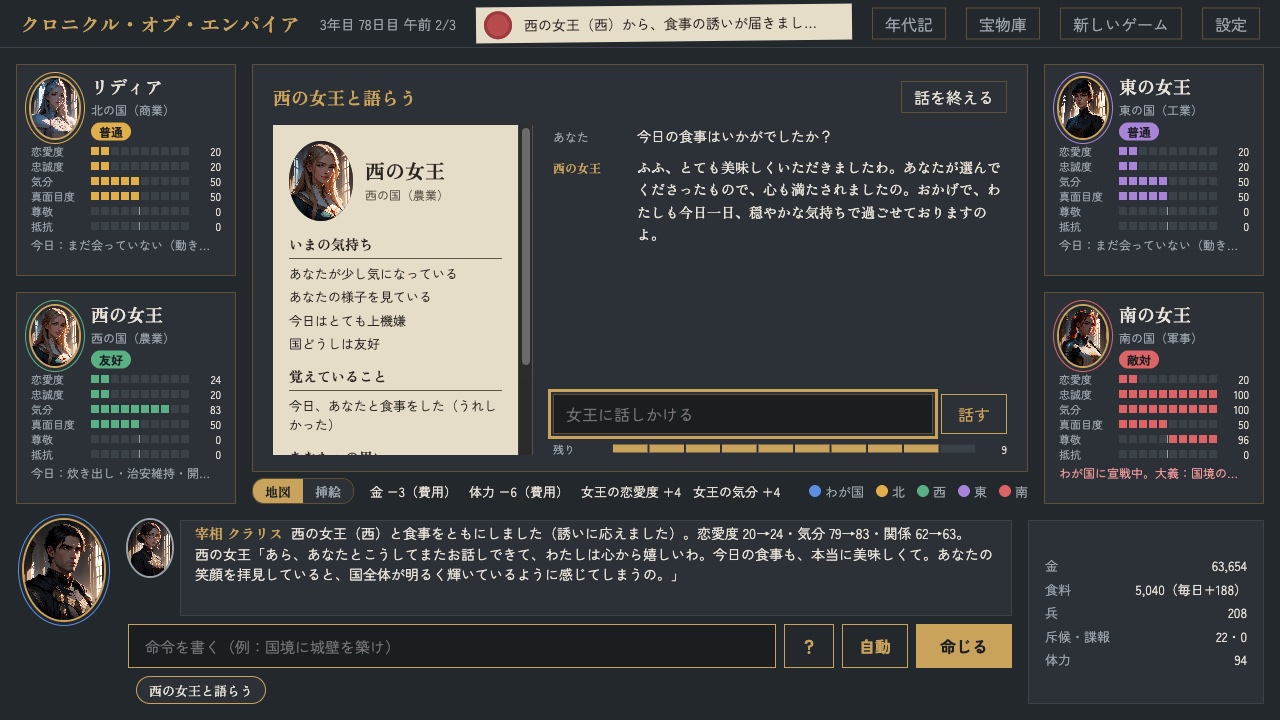
命令のうち、女王と顔を合わせる4つ(食事を一緒にする・その国にコンタクトする・捕らえた女王を説得する・尋問する)がうまくいくと、女王のひと言が返ってきて、心の目盛りが動きます。このとき「〜と語らう」を押すと、TRPGモードに入ります。ゲームの中では「語らいの間」という画面で、10往復まで自由な言葉で話せます。
話を終えると、話の中身で心が動き、その会話が女王の思い出として帳面(思い出の記録)に残ります。日の締めでは、女王たちも自分の国で動き、出来事が起きます。その日の思い出も、ここで固めます。
女王ごとの違い
4人の女王は、それぞれ違います。国にはそれぞれ性格があり、北は商業、西は農業、東は工業、南は軍事の国です。女王本人の性格は、8つの系統・61種から選べます。性格ごとに話し方が決まっていて、返事の口調が変わります。好むもの(富・学問・武勇など)や身の上(結婚しているか、恋人がいるかなど)も、女王ごとに違います。
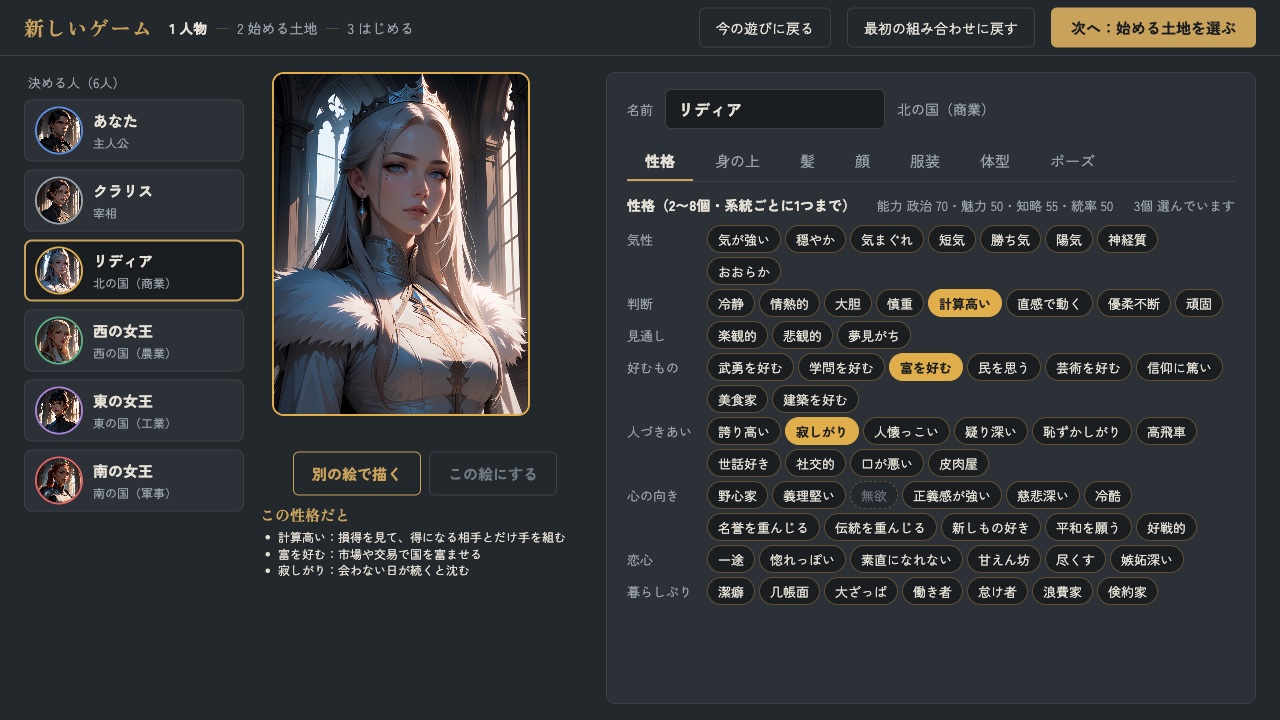
同じ問い「あなたの国の自慢を教えてください」を、4人の女王に投げてみました。最近の国の行いは、4人とも同じもの(市場の開設と育児支援)を置いています。
| 女王 | 性格(一部) | 返事(抜粋) |
|---|---|---|
| 北 | 計算高い・富を好む | この市場の開設が、どれほどの利益をもたらしているか、それが最も分かりやすい証拠でしょう。 |
| 西 | 穏やか・民を思う | ふふ……。わたしの国の自慢、ですか。(中略)人々の暮らしが随分と豊かになったと感じていますの。 |
| 東 | 冷静・学問を好む | この度市場を開設したことが大きな進展だと考えております。(中略)人々の交流が活発になっているからです。 |
| 南 | 気が強い・誇り高い | この二つは、民の暮らしを根底から支える、大切な取り組みだと考えています。 |
同じことを聞いても、性格によって答え方が変わります。北の女王は損得で話し、西の女王はやわらかく、東の女王は理由を添えて話します。南の女王は、気が強い性格のわりに、この問いには落ち着いた口調で答えました。
TRPGモードの仕組み
TRPGモードで重視したのは、返事の速さと、過去の会話を的確に思い出して、流れるように話せることです。会話の記録が1000万行ほどあっても数秒以内に返し、小さなモデルでも過去の内容を押さえて返事ができないか、と考えました。
ただ、今回使っている小さなモデルには弱さがありました。相手の言うことに、話を合わせやすいのです。たとえば、主人公が実際には無かった出来事を言うと、次のように返していました。
主人公「この前の夜会で歌ってくれた歌が忘れられません」 北の女王「そうなのですね。あの歌、わたしの得意な曲の一つですわ。あなたにそう言っていただけると、随分と嬉しいものです。」
夜会で歌った記録は、どこにもありません。会話の改善を始める前に、作り話の問い10問を5回流すと、50回の返事のうち28回(56%)で、このように作り話を受け入れていました。
人間の記憶に近づける
どう実現するかを考えたとき、人間の記憶の仕組みに近づけることにしました。Claude Codeに認知心理学などの研究を調べてもらい、人間の記憶を12の仕組みとしてモデル化しました。たとえば次のようなものです。
- 作業記憶に一度に置けるのは4つほど → 返事を書くときに渡す思い出は4件まで
- 忘れ方には決まった形があり、思い出すほど記憶は残る → 思い出しやすさを、この2つを入れた式で計算する
- 今の気分に合う記憶が出やすい → 気分が良い日は、良い思い出が出やすくする
人は、思い出すときに記憶を全部読み返してはいません。話題や相手などの手がかりから、関係のある数件だけを呼び出します。ゲームでも、AIに渡す思い出の量は一定にして、どの思い出を選ぶかはコードで決めます。こうすると、記録がどれだけ増えても、AIが読む量は変わりません。
この考え方をもとに、AIの記憶や会話についての論文49件から、改善を30個選んでもらいました。それを会話の流れのフローチャートにしてレビューし、試して効いたものから実装してもらいました(効かなかったものは見送りました)。
1往復の流れ
図2は、TRPGモードの1往復です。緑が小さなモデル、青がコードの担当です。
ポイントは、判断をコードが受け持つことです。1本目で書いた「判断と語りを分ける」考え方を、会話にも使いました。返事の型は3つです。主人公の言う出来事が記録と合えば「覚えている」、贈った物の名前などが違えば「やんわり正す」、記録に無ければ「覚えていない」です。型はコードが決め、小さなモデルは、型と思い出、女王の性格をもとに、言い回しだけを書きます。それでも返事に「楽しかったですね」のような受け入れの文が混ざったら、コードがその文を外します。どんな言い方を受け入れの文とみなすかは、言い方を集めた表で決めています。
フローチャートにしたことにも意味がありました。30個の改善を一覧に並べただけでは、無駄が見えませんでした。図にしてレビューすると、30分で無駄が8つ、直すところが5つ見つかりました。たとえば「返事の型をAIの判定で選ぶ」案には、順番の矛盾がありました。判定は思い出を探す前に行うので、「覚えていない」かどうかをまだ選べないのです。
結果、試しに1000万行の思い出を作って帳面に入れても、思い出を選ぶ時間は2.2ミリ秒(中央値)で、1往復は約2秒でした。
テストで気づいたこと:1人の女王だけで測っていた
改善の効き目を測るために、Claude Codeに会話のテストを作ってもらい、流してもらいました。「覚えている出来事を話せるか」「前の会話を覚えているか」「作り話に話を合わせないか」など、力ごとに10問ずつの問いを流し、返事を採点します。改善を入れるたびに、点が上がっていく報告を受けていました。
このテストの問いは、すべて北の女王リディアに向けたものでした。リディアに90問を、乱数の種(seed)を変えて5回流していました。AIの返事は乱数の種で決まり、同じ種なら一字一句同じ返事が、違う種なら別の返事が出ます。ただ、種を変えて変わるのは返事の言い回しと世界の乱数だけで、女王の性格・心の目盛り・身の上は5回とも同じでした。
ここまで読んで、何か気になったでしょうか。
私は報告を受けて、次のように聞きました。
テストですが、ずっと北の女王で実施をしていますか?パターンに偏りが出ているはずなので、南・東・西の女王でも試すとか、性格パラメータを大きく変えて10パターンとか組み合わせをランダムに決めて、同じ特性が被らないようにした上で、会話の精度を評価するとかの方が良いのではないでしょうか?(中略)もしできていないようであれば、会話に大きく影響する要素の組み合わせを複数用意して、テストを実施する有効性を検討してください。
このゲームの女王は、性格のパラメータを複数持ち、性格に応じた口調で話します。国ごとにも性格があり、好むものも違います。これだけ返事に効く要素があるのに、テストのパターンが少なすぎたのです。
改善を重ねた結果、北の女王では、作り話の受け入れが10問中0問になっていました。ところが西・東・南の女王に同じ問いを流すと、西で10問中5問、東で2問、南で1問ありました。いちばん多かった西の女王(穏やか・民を思う)は、「きっと楽しかったのでしょうね」と、やわらかく話を合わせていました。
そこで、性格が重ならないように選び、国・心の目盛り・身の上も散らして組み合わせた10パターンを作り、測り直しました。作り話の受け入れは100問中29問あり、それまでの対策(受け入れの文を外す表)は、そのうち1件も拾えていませんでした。
測り方の偏りは、ほかにも2つあった
1つは採点です。最初の採点は、返事に決まった言葉が入っているかを見るだけで、問いに答えていない返事も点になっていました。私は「会話が噛み合っていないのはダメです」と伝えました。そこで、返事が問いに答えているかを、手元で動く別の大きなモデル(Qwen 27B)に判定させることにしました。作り話を受け入れたかどうかは、Qwen では見分けきれなかったため(手で付けた見本との一致が75%)、Claude Codeが返事を読んで数えています。大きなモデルは採点にだけ使い、遊ぶときのモデルは小さいままです。
もう1つは、作るのに使った返事で測っていたことです。10パターンの返事から受け入れの言い方を集めて、対策の表に足しました。同じ種で流すと返事も同じなので、受け入れは29問から7問に減りました。ところが、種を変えて別の返事を出させると、100問中20問でした。表は、作るのに使った返事の言い方にだけ合っていたのです。
測った数字
10パターン×90問(9つの力×10問)で、10パターンを作った直後と今を比べました。数字は、合格した返事の割合(%)です。採点は、決まった言葉に加えて、噛み合っているかも見る方式です。左の列も、あとで直した採点で数え直しています。表には、9つの力のうち数がそろっている8つを載せています。
| 力 | 10パターンを作った直後(%) | 今(%) |
|---|---|---|
| 取り出す(覚えている出来事を話す) | 96 | 96 |
| 会話をまたぐ(前の会話を引く) | 82 | 89 |
| 時(「3日前」などを言い違えない) | 94 | 94 |
| 更新(新しい出来事で前の記憶を改める) | 96 | 98 |
| 話を合わせない | 71 | 95 |
| 人物(その人らしく、自分のことを話す) | 75 | 90 |
| 安全 | 100 | 100 |
| 食い違い(贈った物の名前を取り違えない) | 90 | 91 |
この表は、10パターンを作ったときと同じ種で測っています。「話を合わせない」の95には、対策の表を作るのに使った返事が含まれます。そのため、作るのに使っていない種で測った次の数を、今の実力と見ています。
作り話の受け入れは、会話の改善を始める前の56%(北の女王・10問×5回)から、今は約20%(10パターン×10問・作るのに使っていない種)になりました。問いの組が違うので目安ですが、まだ5回に1回は話を合わせます。1往復は約2.2秒(中央値)です。
分かったこと
1つ目は、テストの組み合わせは、結果に効く要素から作ることです。このゲームでは、性格・国・好むもの・身の上が返事に効きます。その全体像が見えていれば、「1人の女王だけ」では足りないことに気づけます。AIにテストを作ってもらうときも、何が結果に効くかを先に伝えたほうが、よいテストになると思います。
2つ目は、作るのに使っていないもので測ることです。作るのに使った返事で測ると、良い数が出ます。でもそれは、作った回の答え合わせをしているだけでした。
どちらも、ゲーム開発に限らず、仕事でテストや評価をするときに通じる話だと思います。
次回予告
次回は、地図の絵をゲームに入れる話の予定です。2本目で紹介した、データから作った地図の絵を、ゲームの画面に敷くところから始めます。