MiniMax-H3で長い動画を作る:Macで30秒・60秒・90秒まで伸ばした記録
以前、映像と音声を一緒に作る動画生成AI「MiniMax-H3」を、自分のMacで動かした記録を書きました。そのとき作れたのは、5秒ほどの短い動画です。
今回はその続きとして、30秒・60秒・90秒の長い動画を同じMacで作れるかを試しました。題材は、私が解説動画用に作っているキャラクター「ルニ」です。朝の街を歩き、カフェで仕事をして、夕方の川沿いで手を振るまでの1本の話にしました。
結果から書くと、92秒・18クリップの動画が、同じ人物のまま最後までつながりました。かかった時間は3回に分けて合計約72分です。ただ、途中で止まる落とし穴が1つあり、場面を変えるところには苦手もはっきり出ました。この苦手は、新しい場面の最初の絵を1枚用意することで、あとから直せました。直した版の動画は、記事の最後に置いています。
使った環境はM5 Max・メモリ128GB・macOS 26.6.2、ComfyUI(画像や動画を作る道具を、部品をつないで組み立てるアプリ)は0.43.2です。環境によって結果は変わりますので、1つの参考として見ていただければと思います。
全体像:MiniMax-H3は1回に約15秒まで
最初に、長い動画を作るときの前提を整理します。
MiniMax-H3が1回の生成で作れる長さは、4〜15秒です。15秒より長い動画は、1回では作れません。そこで長い動画は、短いクリップをいくつも作ってつなぐことになります。
ただ、何も考えずにつなぐと、クリップごとに人物と場所が変わってしまいます。そこで今回は、ComfyUIの追加の部品を3つ使いました。
| 部品 | 何をするか |
|---|---|
| Extender | クリップを順に作り、前のクリップの最後のコマを、次のクリップの最初のコマにする。人物と場所が続く |
| RefMod | キャラクターの立ち絵から小さな参照を作り、人物の見た目を保つ。追加の学習はしない |
| 3step LoRA | 生成の手順を3回に減らして速くする追加の部品 |
どれも10月の試しで手元に入れてあった物で、今回新しく入れた物はありません。部品のつながりの図と、今回のワークフロー(部品のつながりを保存したファイル)は、後半の「今回のフロー」の節に置きました。
いまの問題:つなぐと何が困るのか
10月に、記事にはしていない小さな試しで、Extenderで2つのクリップをつなぐところまでは確かめていました。そのとき分かったのは、前の最後のコマを引き継ぐ設定を入れ忘れると、2本目はまったくの別人になることです。逆に、入れておけば同じ人・同じ場所のまま続きました。
ただ、2本と18本では話が違います。気になっていたのは次の3つです。
- 18本つないでも、同じ人のままか(少しずつずれて、最後は別人にならないか)
- 継ぎ目が目立たないか(絵が飛んだり、色が跳ねたりしないか)
- かかる時間(見積もりでは30秒で約20分、90秒なら約1時間。1回で90秒を回して途中で失敗すると、1時間がまるごと消える)
3つ目が一番怖いところでした。そこで、いきなり90秒は作らず、小さく試してから30秒、60秒、90秒と段を分けることにしました。
作った手順
1. 小さく試す:ここで落とし穴が見つかった
まず、小さい画面(608×352)・3クリップで試しました。ここで落とし穴に当たります。
1本目のクリップができた直後に、「ffmpeg(動画を書き出す道具)が見つからない」と出て止まりました。ffmpegは入っているのに、です。
原因は、アプリ版のComfyUI(Comfy Desktop)が起動したときの環境でした。Macでよく使うHomebrewの置き場所が、探す場所の一覧(PATH)に入っていなかったのです。10月の試しは、ターミナルから手で起動していたので気づきませんでした。
直し方は、ComfyUIを一度止めて、同じ設定に探す場所を足して起動し直すことです。困るのは、1本目を作り終えてから止まることでした。いきなり90秒を回していたら、数分を失ってから気づくことになります。小さく試す意味が、ここで出ました。
2. 30秒:6クリップで19分31秒
次に本番の大きさ(864×480)で、5.17秒のクリップを6本作りました。1本ずつの中身は、台本で決めています。
- 1本目:朝の街を歩く
- 2本目以降:横断歩道、パン屋の前、公園の入口、落ち葉の道、ベンチで一息
台本は、MiniMax-H3の公式の書き方に合わせました。1本目は最初のコマが無いので3つの欄だけ、2本目からは「前のクリップのコマを最初に使う」という1行目を足します。人物の説明(銀のポニーテール、紺のスーツ、白いシャツ)は、毎回同じ文で書きました。セリフは入れず、足音や鳥の声などの環境音だけにしています。
できた30秒の動画は30.6秒、作るのにかかった時間は19分31秒でした。1クリップあたり約200秒です。
3. 60秒と90秒は「足して続ける」
ここが今回いちばん役に立ったやり方です。
60秒を作るとき、30秒を作った部品をそのまま使い、クリップの一覧に6本を足しました。そのうえで、作り済みの6本には「もう作らなくてよい」という印を付けて、もう一度実行します。すると、前の6本はそのまま使われ、7〜12本目だけが新しく作られます。90秒も同じように、さらに6本を足しました。
確かめてみると、60秒版の最初の30秒は、30秒版とコマ単位で同じでした。音も同じです。つまり、前に作った部分は1コマも変わらずに、後ろだけが伸びています。
段を分けると、途中で中身を確かめられます。失敗したときの被害も、その段の20〜30分で済みます。気をつけることは2つです。部品の番号(ComfyUIのノードのID)と、動画の大きさ(864×480)を途中で変えないことです。変えると、作り済みの分が使われず、作り直しになります。
結果:92秒、同じ人物のまま最後まで
3本の結果です。
| 動画 | 長さ | 作るのにかかった時間 | ファイルの大きさ |
|---|---|---|---|
| 30秒 | 30.6秒(6クリップ) | 19分31秒 | 12.3MB |
| 60秒(30秒に足す) | 61.4秒(12クリップ) | 29分37秒 | 22.6MB |
| 90秒(60秒に足す) | 92.2秒(18クリップ) | 22分31秒 | 31.0MB |
合計で71分38秒です(表の時間は、秒未満を丸めています)。60秒の段だけ遅いのは、GPUの取り合いのためと考えられます。この段の間だけ、手元で動かしている言語モデルへの問い合わせが14回あり、ほかの段では0回でした。取り合いの無い段は、1クリップ約200〜220秒でした。取り合いがあると、1.5倍ほどになります。
18クリップのうち8クリップから、1コマずつ並べたのが次の画像です。
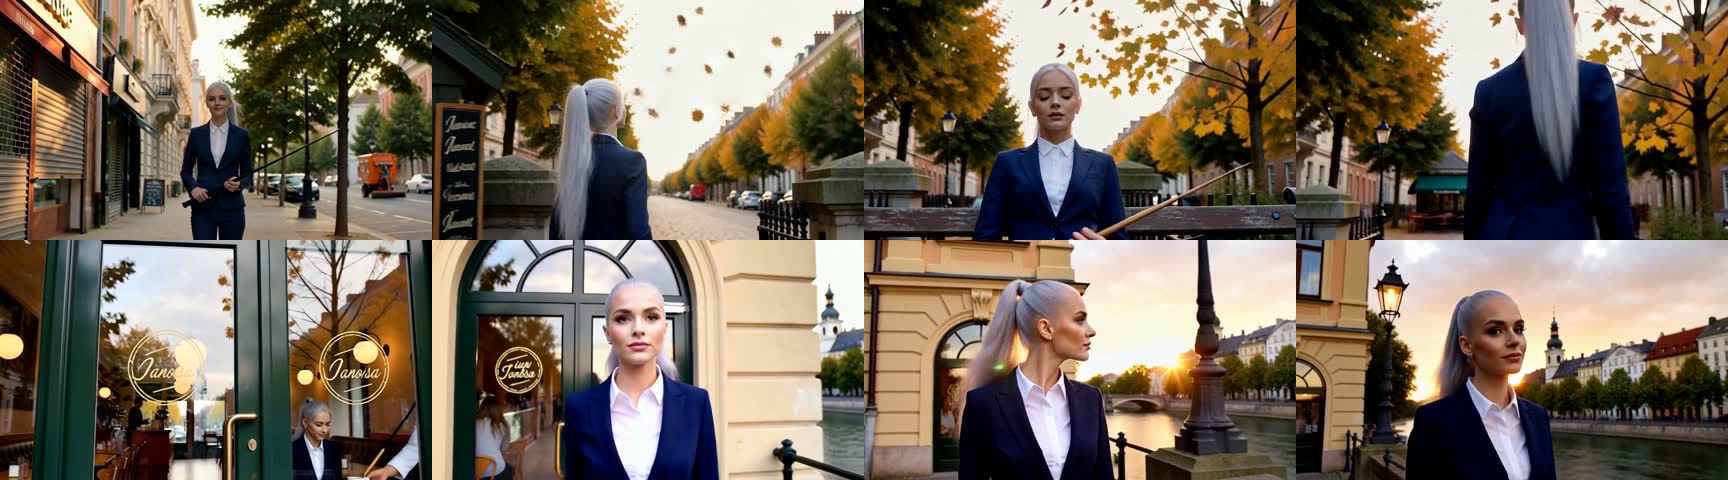
銀のポニーテール、紺のスーツ、白いシャツは、18クリップを通して崩れませんでした。 正面、横、後ろ姿のどれでも、同じ人に見えます。
継ぎ目も見てみました。次の画像は、1本目と2本目の境目、4本目と5本目の境目の前後のコマを並べたものです。
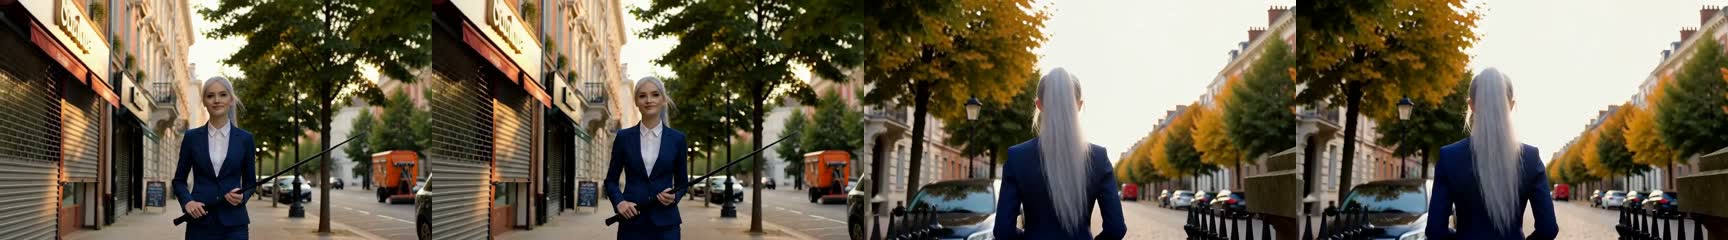
境目の前と後は、ほぼ同じ絵です。17か所の境目のどこでも、絵の飛びや色の跳ねは見えませんでした。
うまくいかなかったこと
もちろん、全部がうまくいったわけではありません。気になった点を4つ挙げます。
1つ目は、場所を変えると前の構図を引きずることです。「カフェに入る」クリップが、扉のガラス越しに店の中を見るコマで終わりました。すると次の5本は、台本に「店の中の窓際の席」と書いたのに、ずっとガラスの外から写したままになりました。前の最後のコマを引き継ぐ仕組みなので、構図も引き継いでしまうのです。
2つ目は、顔つきが少しずつ変わることです。髪と服は続きますが、カフェの寄りのコマでは、最初より大人びた顔に見えました。持たせた指し棒も、後半では見えなくなりました。
3つ目は、音です。MiniMax-H3の音は小さく、元の平均は−32〜−34dBでした。音量をそろえる処理(loudnorm)で全体の大きさは整えられます。ただ、クリップごとに環境音の大きさが違い、その差は残りました。動きも、クリップの頭で一度止まってから始まります。継ぎ目が分かるのは、絵ではなく動きと音でした。
4つ目は、看板の文字です。カフェの看板の文字は崩れて、読めない言葉になりました。実在の会社の印に似た形が、車などに出るコマもありました。人に見せる動画では、使うコマを選ぶ必要があります。
場面替えを直す:場面の頭の絵から始める
うまくいかなかったことの1つ目、場所を変えると前の構図を引きずる点は、あとから直しました。
どこで引きずったか
90秒の台本で、場所が前のクリップと変わるのは5か所です。そのうち、公園に入るところと公園を出るところは、歩いて着く流れなので、前のコマから続けても新しい場所に入れました。
引きずったのは、残りの3か所です。
- 9本目(カフェの中):扉のガラスの外から写したまま、5本続いた
- 16本目(夕方の川沿い):約3.5秒、カフェの入口のままだった
- 18本目(家の前):川沿いのまま、家に着かなかった
4つのやり方を比べた
比べは、90秒の動画とは別に、1クリップだけを作って行いました。前のクリップは7本目(公園を出て、通りを歩く後ろ姿で終わる)です。その続きに、9本目の文(店の中の窓際の席)で、通りからカフェの中へ移るクリップを、4つのやり方で1回ずつ作りました。
| やり方 | 新しい場所に入るまで | 気づいたこと |
|---|---|---|
| 今まで(前のクリップの最後のコマから続ける) | 5秒間ずっと通りのまま | 前の場所から出られない(90秒の動画では、扉のガラスの外にとどまった) |
| 文でカット(台本に「1秒目で店の中に切り替わる」と書く) | 約1〜1.3秒遅れる | 頭の1秒は前の場所 |
| 場面の頭の絵から(新しい場所の絵を作り、最初のコマにする) | 0秒目から | 場所と構図を自分で決められる |
| 参照だけ(最初のコマを渡さず、人物の参照だけで作る) | 0秒目から | 顔が手本から離れた。窓に大きな文字が出た |
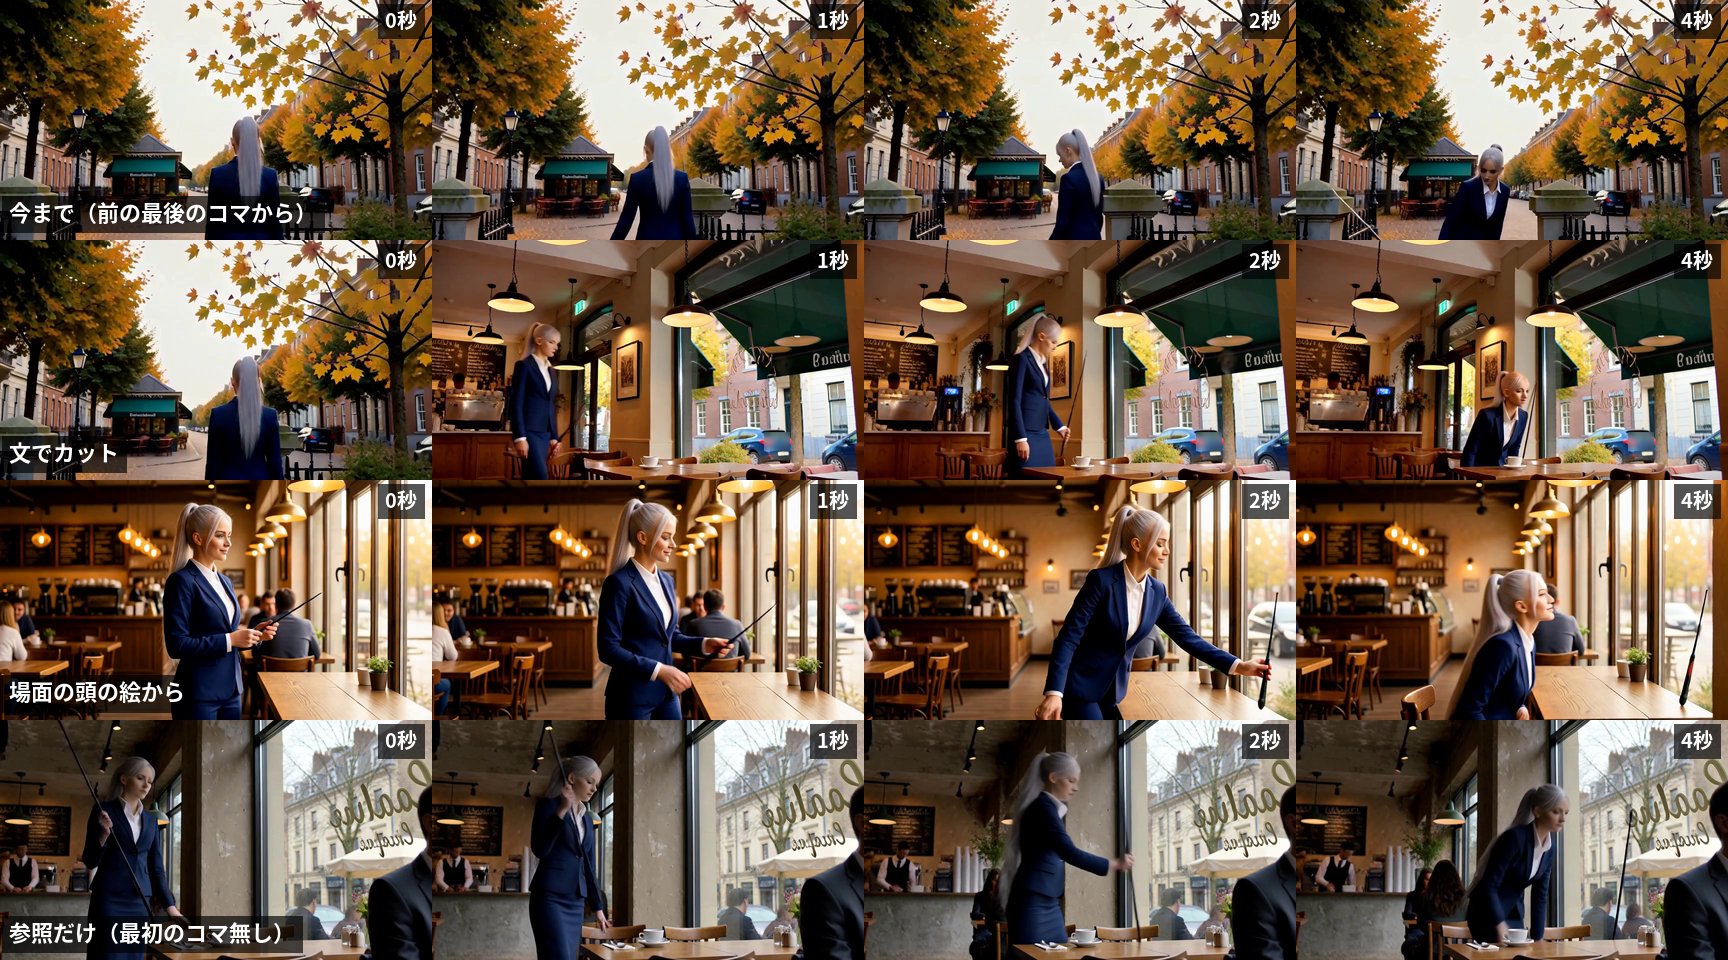
いちばん良かったのは、場面の頭の絵を作るやり方です。0秒目から新しい場所で始まり、場所と構図も自分で決められます。MiniMax-H3の生成時間は増えず、増えるのは絵1枚を描く時間だけです。
場面の頭の絵の作り方
頭の絵は、画像を編集するAI「Qwen-Image-Edit」(2511版・4ステップ)で描きました。渡したのは、次の3つです。
- 前のクリップの最後のコマ(今の人物と服の手本)
- 顔の手本(動画の中で、顔が大きく正面を向いたコマ)
- 新しい場所の文(例:カフェの中の、大きな窓の横のテーブルの脇に立っている)
顔の手本を足したのは、最後のコマが後ろ向きだと、顔が写っていないためです。絵は1280×720で描き、動画と同じ864×480に縮めました。1枚あたり約80〜100秒です。
作った絵は、Extenderのクリップの「First frame」(最初のコマ)に入れます。ファイルで書くときは、そのクリップのfirst_sourceをprevious_clipからmanualに変え、first_frameに絵を入れます。
なお、配られている4ステップ版の重みは、fp8という形式です。手元のMacでは、そのまま読み込むと止まったので、bf16という形式に直して使いました(約41GB)。
90秒を作り直した
9・16・18本目の3か所だけを、頭の絵から始めるように変えて、90秒を作り直しました。ほかのクリップの台本・種・設定は、前の版と同じです。
頭の絵には、前のクリップの最後のコマが要ります。そこで、4段に分けて作りました。1〜8本目を作ってから9本目の頭の絵を描き、9〜15本目を作る、というように、足して続けるやり方で進めます。
結果は、3か所とも0秒目から新しい場所で始まりました。カフェの中、夕方の川沿い、家の前と、台本どおりの場所に入れています。
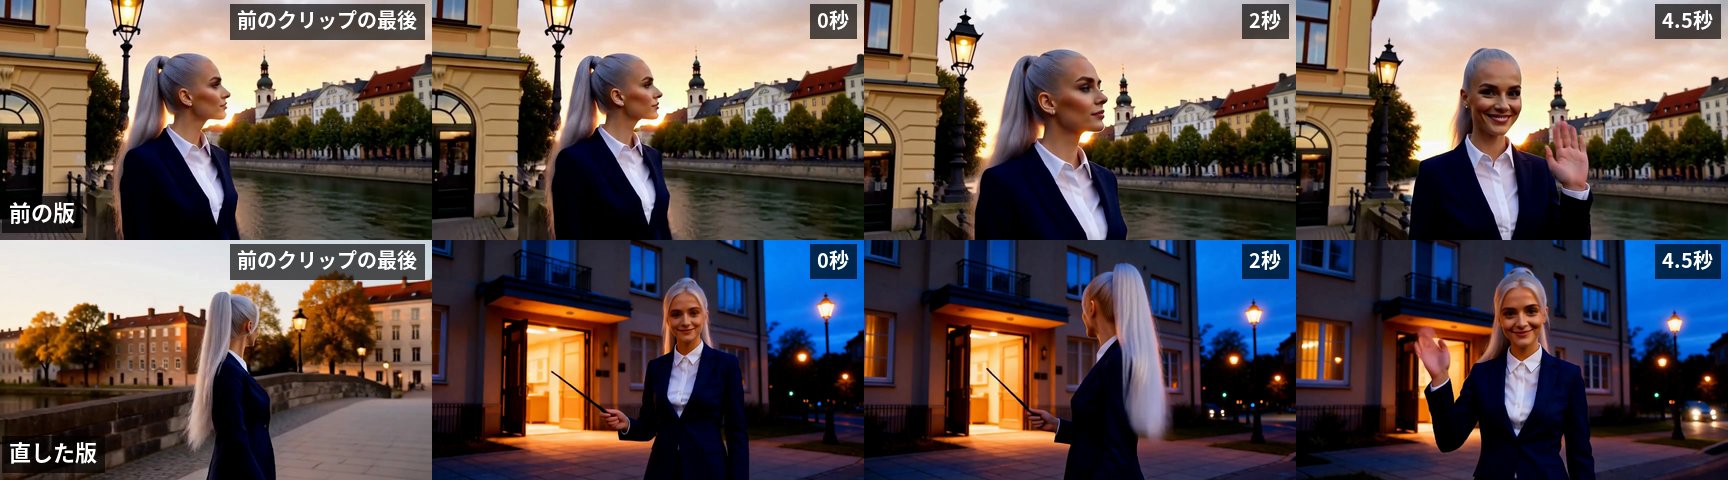
かかった時間は、MiniMax-H3が4段で66分42秒、頭の絵3枚が4分29秒で、合わせて約71分でした。前の版を残すため1本目から作り直したので、前の版の合計(71分38秒)とほぼ同じです。ただし、前の版の合計には60秒の段の取り合いの分が入っているので、単純には比べられません。1〜8本目は、前の版とコマ単位で同じでした。
残った課題
直した版でも、気になる点が3つ残りました。
1つ目は、明るさの飛びです。18本目の頭の絵を「夕暮れ」の文で描いたところ、橋の上の夕焼けから、青い夕暮れの家の前へ、明るさが一気に変わりました(上の図の下の段)。頭の絵の文で、時刻と光の様子を前のクリップにそろえる必要があります。
2つ目は、顔の似かたです。顔を見分けるAIで、手本の顔との似かたを、1秒ごとの数で見ました(1に近いほど似ている)。平均は前の版が0.35、直した版が0.33です。顔が見つかったコマ(前の版50、直した版56)のうち、0.25を下回ったコマは、10コマから18コマに増えました。目で見ると同じ人に見えますが、数では少し離れています。原因は、まだ分けて調べていません。
3つ目は、音です。場面が変わる境目では、環境音の大きさも変わります(境目の前後で6.6〜12.5dB)。前の版の同じ境目でも1.8〜12.0dBあり、やり方による差とは言えません。
考察:「長い動画」は作れる、「長い話」には工夫が要る
今回分かったのは、1本15秒という壁は、つなぐことで越えられるということです。同じ人物のまま、Macで92秒まで伸ばせました。時間も、1クリップ約200秒と、長さにほぼ比例して見積もれます。
一方で、前のコマを引き継ぐ仕組みには、そのぶん引きずる性質もあります。人物が続くのは良いことですが、場所を大きく変えたいときには、それが邪魔になりました。そこで、場面が変わるところだけ、新しい最初のコマを自分で用意すると、場所を切り替えられました。人物を続ける仕組みはそのままにして、場面の境目だけを自分で決める形です。長い話を作るには、この組み合わせが現実的だと考えています。
音には、別の工夫が要ります。クリップごとに作られる音をつなぐより、BGMや語りを別に作って全体に敷くほうが、聞きやすい動画になると思います。
今回のフロー:サンプルのワークフロー
試したい方のために、今回のワークフローを置いておきます。まず、部品のつながりです。
流れは4段です。モデルを読み込み、RefModで人物の参照を付け、Extenderでクリップを順に作り、最後に1本のMP4へ書き出します。台本は、Extenderの「クリップの一覧」に、クリップごとの文・長さ・種(乱数の元の数)として入っています。場所が変わるクリップだけは、「場面替えを直す」の節で描いた「場面の頭の絵」が最初のコマです。
組み立てるときに気をつけるところが2つあります。
- RefModは、Continuum RefMod Bridgeという部品でモデルに付けてから、Extenderに渡します。Extenderには、RefModを直接つなぐ口がありません
- SigmaShift(MiniMax-H3用に、ノイズを減らしていく配分を決める部品)は、通したあとのモデルをExtenderに渡します。10月の試しでは、通す前のモデルを渡していました
ファイル
| ファイル | 中身 |
|---|---|
| h3-long-30s.json | 30秒を作る(6クリップ・864×480・3ステップ) |
| h3-long-60s-add.json | 30秒に6本足して60秒にする(先頭の6本に作り済みの印) |
| h3-long-90s-add.json | 60秒に6本足して90秒にする(先頭の12本に作り済みの印) |
どれもComfyUIのAPI形式です。ComfyUI 0.43.2では、画面にドラッグすると、クリップの一覧ごと開けることを確かめました。配るのは前の版(頭の絵なし)です。頭の絵は、自分の動画の最後のコマから描くので、ファイルには入れていません。
配るにあたって、手元のフォルダ名と画像の名前を置き換えました。もう1か所、クリップの一覧に、作ったときと同じモード(fl2va)を書き足しています。これが無いと、画面で開いたときに、Extenderが一覧を空の1本へ戻してしまいます。自分でAPI形式のファイルを作る方は、気をつけてください。
使ったモデルと部品
ワークフローが読むモデルは、次の5つです。合わせて約44GBあります。
| 役割 | ファイル | 大きさ | 置くフォルダ |
|---|---|---|---|
| 本体 | minimax_h3_fl2va_pruned_int8_convrot.safetensors |
20.97GB | diffusion_models |
| 文を読む | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
15.69GB | text_encoders |
| 映像のVAE | minimax_h3_video_vae_fp16.safetensors |
5.21GB | vae |
| 音声のVAE | minimax_h3_audio_vae_fp32.safetensors |
0.61GB | vae |
| 3step LoRA | TaoMate-H3-3step-ComfyUI.safetensors |
1.24GB | loras |
上の4つはHugging FaceのComfy-Org/MiniMax-H3、3step LoRAはCZMartin22/TaoMate-H3-3step-ComfyUIにあります。
ExtenderとRefModは、ComfyUIに足す部品集(カスタムノード)です。3step LoRAは、上のモデルの表に入れました。手元の版も書いておきます。
| 部品 | 配布元 | 手元の版 | ライセンス |
|---|---|---|---|
| Extender | tritant/ComfyUI_MiniMax_H3_Extender | 3.0.12 | Apache 2.0 |
| RefMod | Luisacaotica/ComfyUI-MiniMaxH3Mod | 0.2.7 | MIT |
モデルと3step LoRAのライセンスは、MiniMax H3 Community Licenseです。どのライセンスも、2026年11月2日に配布元の表示で確かめました。
使う順番
- モデル5つと部品2つを入れる
- キャラクターの立ち絵4枚を、ComfyUIのinputフォルダに
character_1.png〜character_4.pngの名前で置く(画像を読み込む部品で選び直してもよい) - h3-long-30s.jsonを開いて実行する
- 30秒を確かめてから、h3-long-60s-add.jsonを開いて実行する。先頭の6本は作らず、ディスクに残った結果をそのまま使う
- 同じように、h3-long-90s-add.jsonで90秒にする
60秒と90秒のファイルは、前の段を同じMacで作り終えていることが前提です。Extenderは、開いたとき、ディスクに残った結果を調べます。作り済みの印は、その結果どおりに付け直されます。画面で印を付ける欄は、クリップごとの「Validated」です。
自分のキャラクターで作るときは、台本の人物の説明(銀のポニーテール、紺のスーツなど)を書き換えます。60秒と90秒のファイルにも、先頭に同じ台本が入っています。書き換えるときは、3つのファイルで同じように書き換えてください。Extenderの説明書によると、台本や種が変わったクリップから後ろは、作り済みの印が外れて作り直しになります。
まとめ
- MiniMax-H3は1回に最大約15秒。長い動画は、前のクリップの最後のコマから続けて、短いクリップをつなぐ
- Macでも、同じ人物のまま92秒(18クリップ)をつなげた。かかった時間は864×480で約72分
- 長いものは段に分け、作り済みに「もう作らなくてよい」印を付けて足して続ける。前の部分は1コマも変わらない
- アプリ版のComfyUIは、ffmpegが見つからず1本目の後で止まることがある。長い実行の前に小さく試す
- 場所を変えると前の構図を引きずる。場所が変わるクリップだけ、場面の頭の絵(Qwen-Image-Edit)を最初のコマにすると、0秒目から新しい場所で始まった。90秒で3か所、頭の絵を描く時間は3枚で約4.5分
- 音はクリップごとに大きさが違う。頭の絵の明るさは、前のクリップにそろえる必要がある。顔の似かたは、数では少し下がった(平均0.35→0.33)
- 今回のワークフロー(30秒・60秒・90秒の3つ)を置いた。ComfyUIの画面にドラッグすると、台本ごと開ける
なお、MiniMax-H3のライセンスでは、機械が作った内容を公開するときは、そう分かるように示すことになっています。この記事に載せた動画とそのコマは、どれもMiniMax-H3で作ったものです。場面の頭の絵だけは、Qwen-Image-Editで描いた絵を最初のコマにしています。
次は、頭の絵の時刻と明るさを前のクリップにそろえて、場面の境目で明るさが飛ぶのを抑えられるかを試してみたいと思います。
完成した動画:場面替えを直した90秒
最後に、場面替えを直した版の動画を置いておきます。朝の街からカフェ、夕方の川沿い、家の前までの18クリップです。